Flujo de datos operacionales
Un flujo que saca datos de una base de datos accesible solo desde una red interna y los entrega, verificados y firmados, a dashboards web en vivo.
- Diseño y desarrollo
- 2025–2026
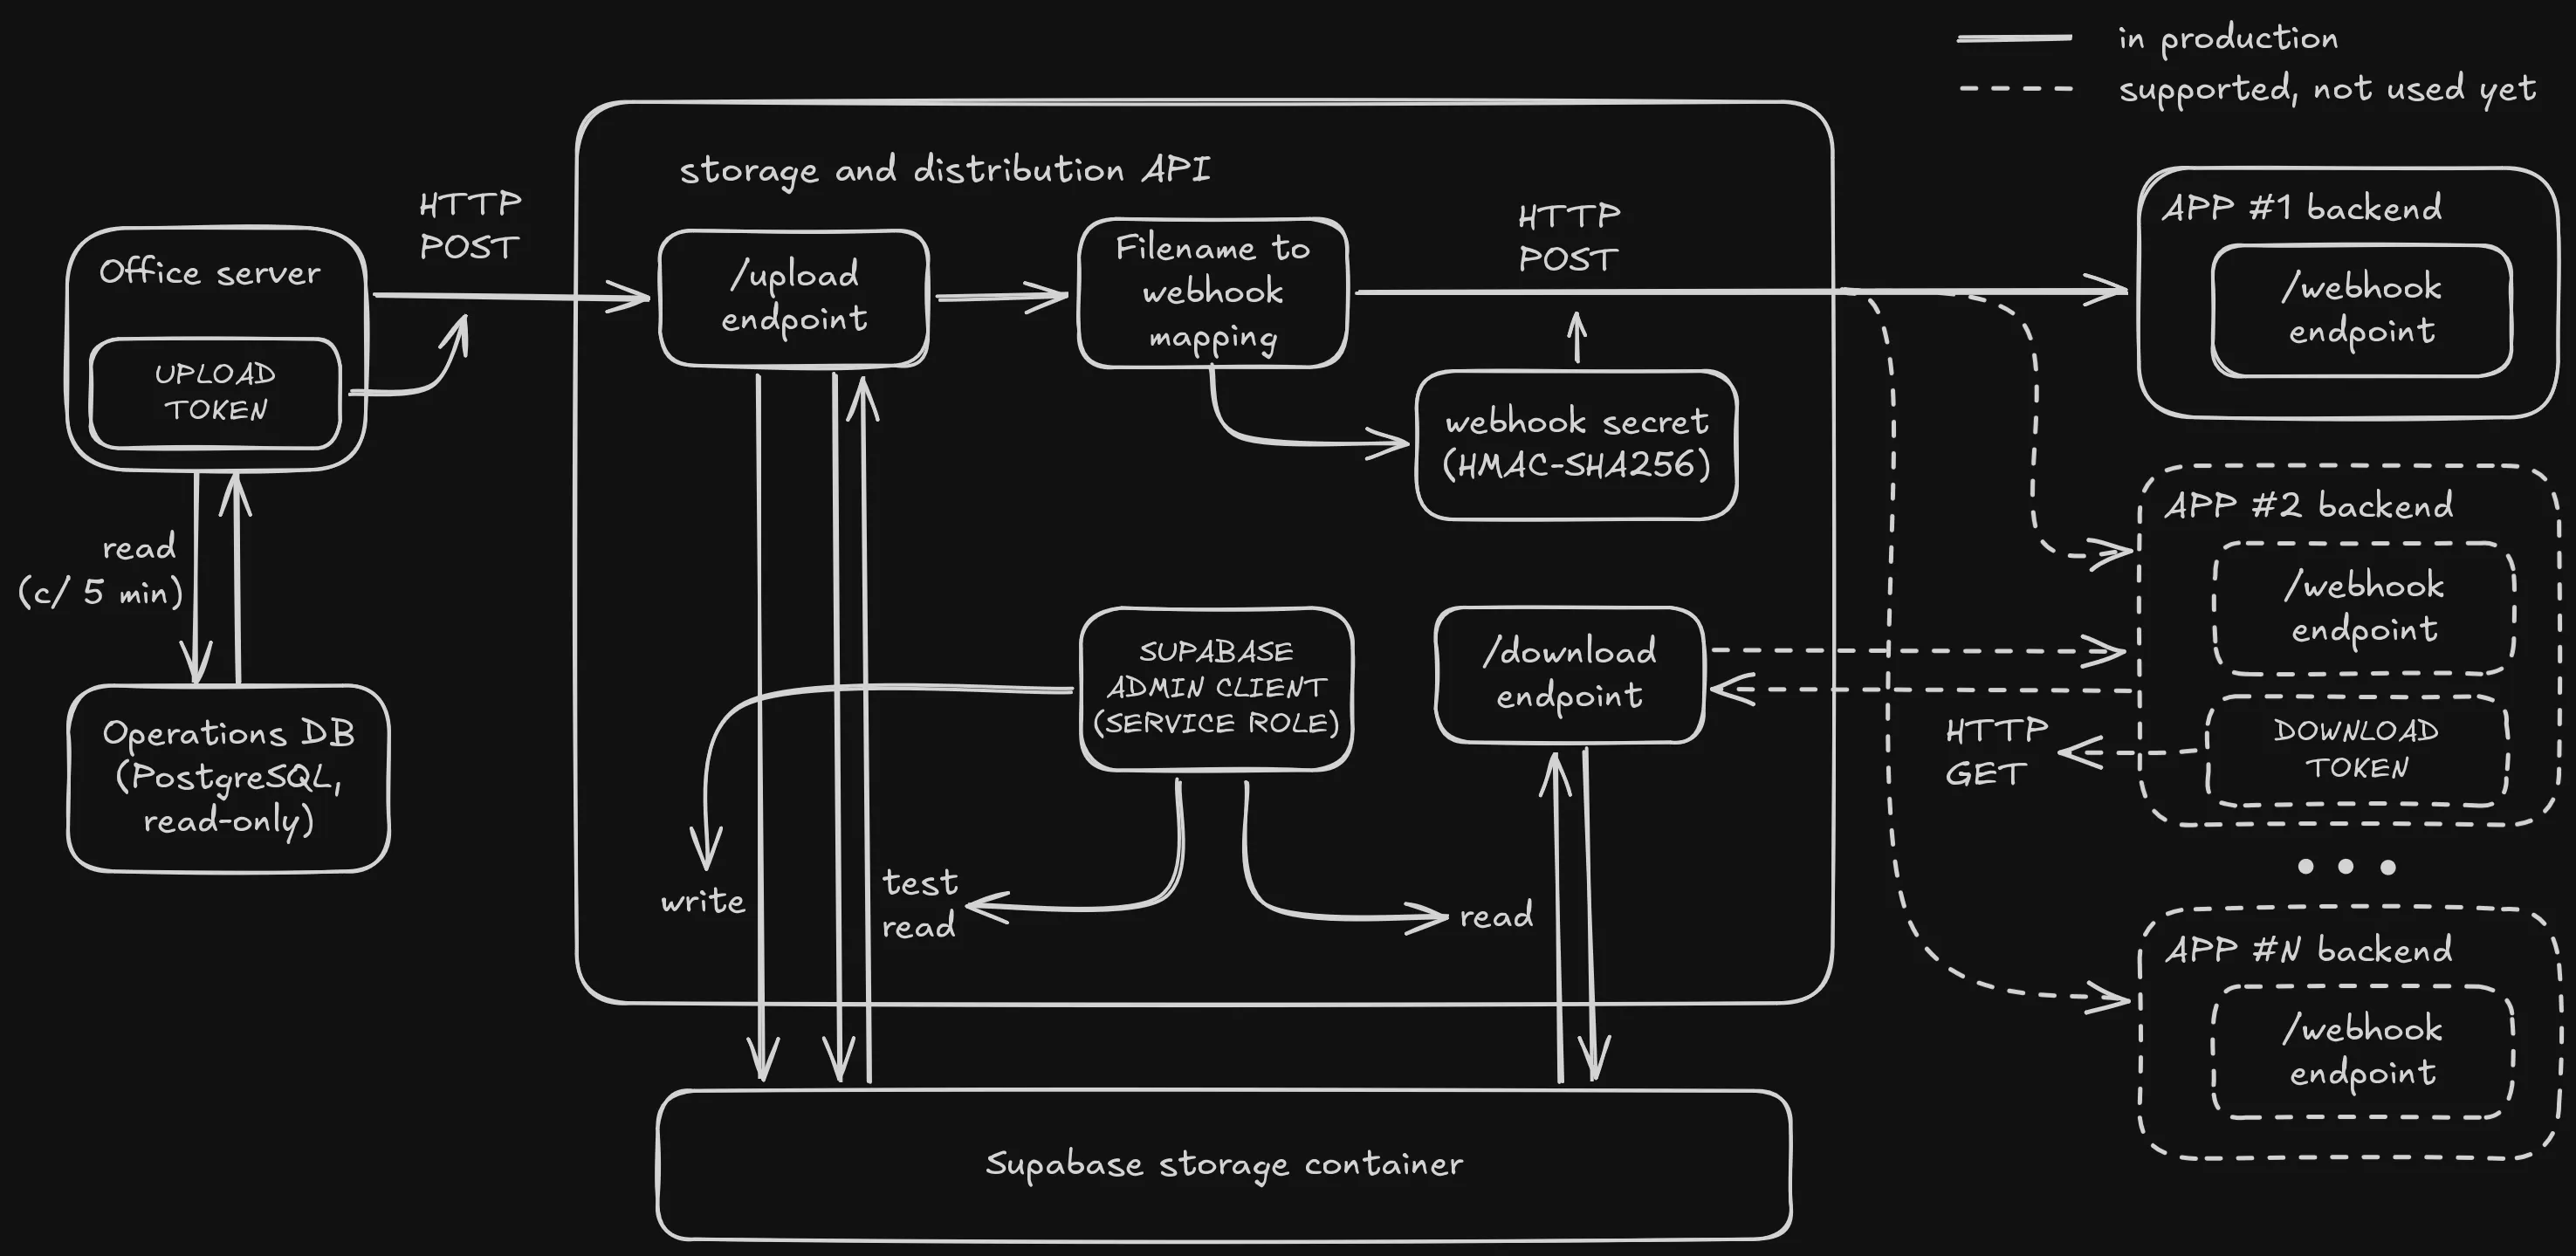
Un organismo público nacional necesitaba un dashboard en vivo de sus recursos operativos, construido con datos de su sistema de operaciones: una base de datos PostgreSQL que el equipo de desarrollo solo podía leer, a través de una réplica accesible únicamente desde la red interna del organismo. Diseñé y construí, por mi cuenta, el flujo que salva esa distancia y el servicio de almacenamiento y distribución que está en su centro.
Extracción
- Cada 5 minutos, una tarea programada en un servidor de oficina ejecuta un script en Python (psycopg2, pandas) sobre la réplica de solo lectura, así el sistema en producción nunca se toca.
- La consulta, de 335 líneas de SQL, une siete tablas y traduce los códigos internos del sistema a categorías legibles mediante 27 expresiones CASE con más de cien ramas.
- Antes de salir de la red, los datos se limpian: se reparan textos que mezclan Latin-1 y UTF-8, y los campos guardados como objetos PHP serializados se convierten a JSON.
Almacenamiento y distribución
Un servicio pequeño (Deno, Supabase Storage) recibe los datos y los reparte:
- Subida autenticada, con su propio token, a un bucket privado. Cada archivo se relee justo después de escribirse, para confirmar que quedó guardado íntegro.
- Envío a suscriptores. Cada archivo está asociado a las apps que lo usan; en cada actualización, cada una recibe los datos nuevos en un webhook firmado con HMAC-SHA256, que verifica antes de aceptarlo.
- Descarga a pedido. Un endpoint
/download, con otro token, para las apps que prefieren ir a buscar los datos. - Un solo juego de llaves. Solo el servicio guarda las credenciales del almacenamiento: ni el servidor de oficina ni las apps acceden nunca directamente a él.
El diseño es genérico: agregar un conjunto de datos o un suscriptor es una línea en el mapeo.
Del lado del dashboard
El backend del dashboard verifica cada entrega firmada y guarda los datos más recientes en una caché para su frontend. Solo el personal del organismo puede abrirlo: el inicio de sesión es con Firebase Authentication, con Google como único proveedor, tras una pantalla de consentimiento OAuth restringida al Google Workspace del organismo, y el backend verifica el token de sesión en cada solicitud.
Resultados
- Datos que nunca salían de la red interna ahora alimentan un dashboard en vivo, actualizado cada 5 minutos, sin abrir la base de datos al exterior ni tocar el sistema en producción.
- Privado de punta a punta: réplica de solo lectura, subida autenticada con token, almacenamiento privado, entrega firmada y un dashboard solo para el personal. Cada paso exige credenciales.
- Infraestructura reutilizable: otros conjuntos de datos y apps se conectan al mismo servicio con una línea en su mapeo, sin servidores ni credenciales nuevos.